


À propos du cours
Un robot peut-il vraiment comprendre ce qu’il voit ?
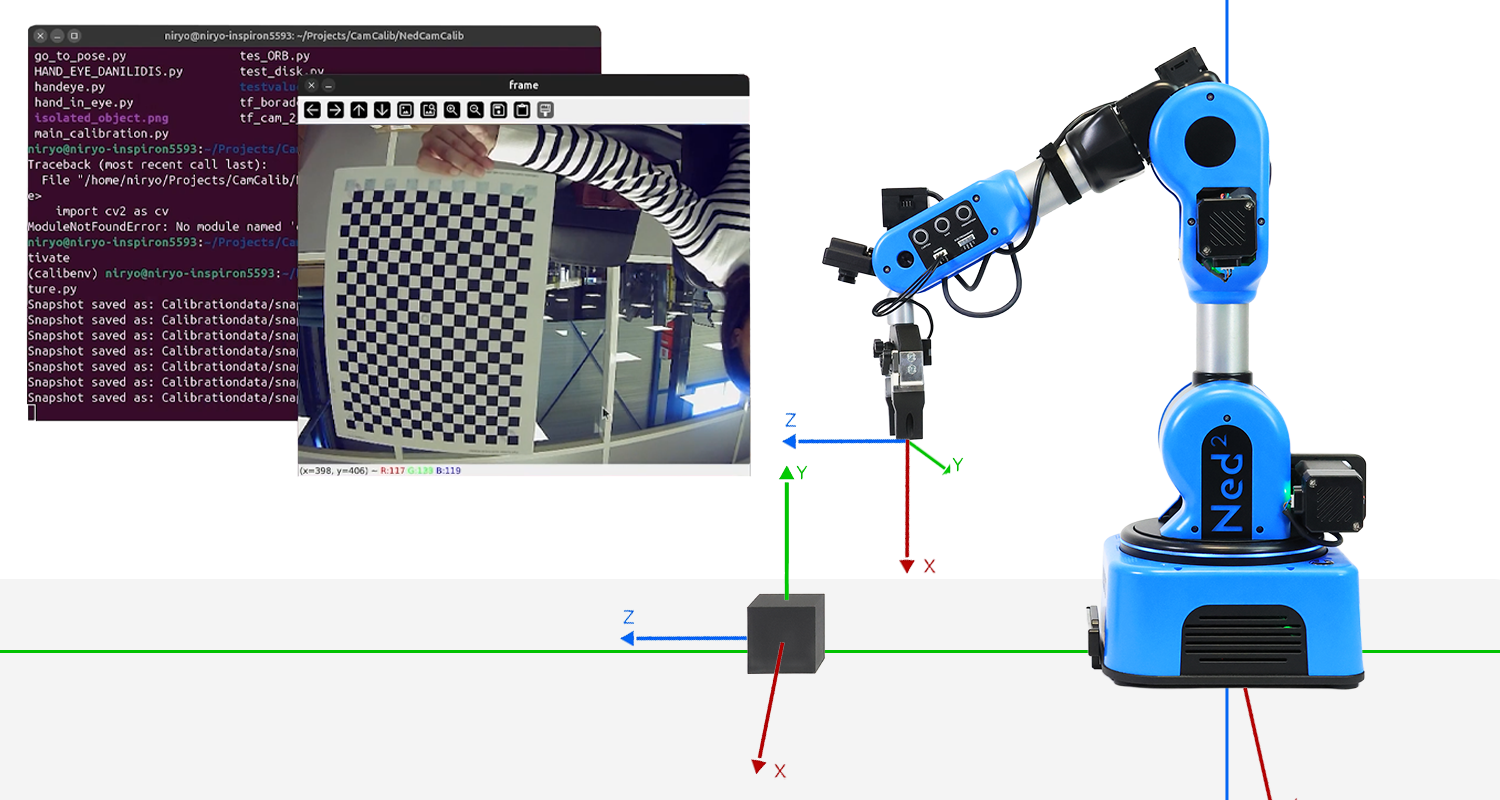
Ce TP vous emmène dans une aventure technique et concrète, où vous partirez d’une simple image pour arriver à une action robotique précise. Avec une seule caméra montée sur le Niryo Ned2, vous construirez toute une chaîne de perception, de la calibration à la détection d’objet, jusqu’à la saisie en temps réel.
Le système de vision actuellement en place repose sur une caméra monoculaire montée sur le poignet du robot et un workspace calibré à l’aide de cibles visuelles (tags). Voici les spécifications techniques de cette caméra embarquée :
- Type de capteur : IMX322 (CMOS)
- Résolution : 640 × 480
- Taille des pixels : 12.8 × 11.6 μm
- Champ de vision (FOV) : environ 104°
- Focale : environ 3 mm
Cette configuration, bien que fonctionnelle, présente plusieurs limitations techniques et méthodologiques :
- Nécessité d’utiliser des tags visuels pour guider le robot.
- Configuration du workspace exigeante, qui doit rester fixe et précisément calibrée.
- Forte sensibilité aux erreurs, qu’il s’agisse de mouvements du robot ou de modifications du setup.
- Vulnérabilité face aux conditions d’éclairage, aux ombres ou aux reflets.
- Capacité de détection limitée à quelques objets rigides prédéfinis.
Quand un humain regarde un objet, il est capable d’estimer sa position, sa distance et son orientation presque instinctivement. Notre cerveau est entraîné depuis la naissance à comprendre la profondeur, à interpréter les ombres, les tailles relatives, les mouvements et à croiser les informations entre nos deux yeux. C’est un processus riche, complexe, mais complètement transparent pour nous.
Une caméra, elle, ne voit pas comme un humain. Elle capte uniquement une projection 2D d’un monde 3D. Elle n’a pas de notion de profondeur, ni de compréhension du contexte de la scène. Estimer la pose d’un objet (c’est-à-dire sa position et son orientation dans l’espace) à partir d’une seule image est donc une tâche fondamentalement ambiguë et mal posée.
À cela s’ajoutent plusieurs défis spécifiques au contexte industriel de ce projet :
- Utilisation exclusive d’une caméra monoculaire, sans accès direct à la profondeur.
- Caméra, mobile car embarquée sur le robot, rendant son repérage complexe.
- Absence de capteurs supplémentaires (stéréo, LIDAR, etc.).
- Bruit de la caméra, éclairage, résolution.
Face à toutes ces difficultés, l’objectif de ce TP est de construire une chaîne de traitement d’image robuste, fiable et cohérente, dans laquelle la seule source d’information est l’image d’une caméra monoculaire embarquée, et la finalité est de guider un bras robotique pour qu’il interagisse correctement avec un ou plusieurs objets dans son environnement.
Le TP vise ainsi à concevoir un système qui :
- Fonctionne sans workspace préconfiguré ni cibles visuelles,
- S’adapte à une caméra embarquée, mobile avec le robot,
- Permette une reconnaissance flexible d’un large panel d’objets à partir de leurs modèles CAO,
- Offre une estimation 6D de la pose (position + orientation) dans le repère de base du robot,
- Détecte plusieurs objets simultanément avec sélection dynamique,
- Reste robuste aux variations d’environnement.
Compétences travaillées
- Comprendre comment une caméra monoculaire perçoit un environnement 3D et comment la calibrer.
- Estimer la pose 6D d’un objet à partir d’une seule image avec solvePnP.
- Appliquer la calibration main-œil pour relier vision et action.
- Manipuler des transformations de repères pour piloter un bras robotisé.
- Construire une boucle perception → action complète pour la saisie d’objets.
- Acquérir une méthodologie applicable aux projets industriels et à la recherche.
Contenu du cours
À Propos de l'Auteur
Options d’inscription
Pipeline Vision : De la Caméra à la Préhension avec le Niryo Ned2
- Length: 16h
- Content Type: Lab
- Programming: Python
- Equipment: Bundle STEM
Un robot peut-il vraiment comprendre ce qu’il voit ?
Ce TP vous emmène dans une aventure technique et concrète, où vous partirez d’une simple image pour arriver à une action robotique précise. Avec une seule caméra montée sur le Niryo Ned2, vous construirez toute une chaîne de perception, de la calibration à la détection d’objet, jusqu’à la saisie en temps réel.
Le système de vision actuellement en place repose sur une caméra monoculaire montée sur le poignet du robot et un workspace calibré à l’aide de cibles visuelles (tags). Voici les spécifications techniques de cette caméra embarquée :
- Type de capteur : IMX322 (CMOS)
- Résolution : 640 × 480
- Taille des pixels : 12.8 × 11.6 μm
- Champ de vision (FOV) : environ 104°
- Focale : environ 3 mm
Cette configuration, bien que fonctionnelle, présente plusieurs limitations techniques et méthodologiques :
- Nécessité d’utiliser des tags visuels pour guider le robot.
- Configuration du workspace exigeante, qui doit rester fixe et précisément calibrée.
- Forte sensibilité aux erreurs, qu’il s’agisse de mouvements du robot ou de modifications du setup.
- Vulnérabilité face aux conditions d’éclairage, aux ombres ou aux reflets.
- Capacité de détection limitée à quelques objets rigides prédéfinis.
Quand un humain regarde un objet, il est capable d’estimer sa position, sa distance et son orientation presque instinctivement. Notre cerveau est entraîné depuis la naissance à comprendre la profondeur, à interpréter les ombres, les tailles relatives, les mouvements et à croiser les informations entre nos deux yeux. C’est un processus riche, complexe, mais complètement transparent pour nous.
Une caméra, elle, ne voit pas comme un humain. Elle capte uniquement une projection 2D d’un monde 3D. Elle n’a pas de notion de profondeur, ni de compréhension du contexte de la scène. Estimer la pose d’un objet (c’est-à-dire sa position et son orientation dans l’espace) à partir d’une seule image est donc une tâche fondamentalement ambiguë et mal posée.
À cela s’ajoutent plusieurs défis spécifiques au contexte industriel de ce projet :
- Utilisation exclusive d’une caméra monoculaire, sans accès direct à la profondeur.
- Caméra, mobile car embarquée sur le robot, rendant son repérage complexe.
- Absence de capteurs supplémentaires (stéréo, LIDAR, etc.).
- Bruit de la caméra, éclairage, résolution.
Face à toutes ces difficultés, l’objectif de ce TP est de construire une chaîne de traitement d’image robuste, fiable et cohérente, dans laquelle la seule source d’information est l’image d’une caméra monoculaire embarquée, et la finalité est de guider un bras robotique pour qu’il interagisse correctement avec un ou plusieurs objets dans son environnement.
Le TP vise ainsi à concevoir un système qui :
- Fonctionne sans workspace préconfiguré ni cibles visuelles,
- S’adapte à une caméra embarquée, mobile avec le robot,
- Permette une reconnaissance flexible d’un large panel d’objets à partir de leurs modèles CAO,
- Offre une estimation 6D de la pose (position + orientation) dans le repère de base du robot,
- Détecte plusieurs objets simultanément avec sélection dynamique,
- Reste robuste aux variations d’environnement.
- Étudiants inscrits: 168
- Length: 16h
- Content Type: Lab
- Programming: Python
- Equipment: Bundle STEM
Ce cours inclus
Ressources